







Traktuj odzyskiwanie SQLite jako kontrolowane odzyskiwanie danych
Aby odzyskać uszkodzoną bazę danych SQLite, zachowaj spójną kopię bazy danych i powiązanych z nią plików dziennika, a następnie porównaj istniejące kopie zapasowe przed użyciem rodzimych narzędzi odzyskiwania. Nie zaczynaj od usunięcia pliku WAL lub uruchomienia poleceń czyszczenia na jedynym źródle. Prawidłowy pierwszy krok zależy od tego, czy problemem jest uszkodzenie, brak zatwierdzonych transakcji, zablokowana baza danych czy aplikacja oczekująca innego schematu.
Natywne narzędzia SQLite mogą wyodrębniać przydatne dane, ale odzyskana baza danych nadal wymaga sprawdzenia struktury i aplikacji. Otwarty plik może zawierać brakujące, zduplikowane lub zmienione rekordy. Dlatego należy oddzielić udaną ekstrakcję od akceptacji wyniku. W tym przewodniku skupiono się na kopiach roboczych, istniejących kopiach zapasowych, zachowanym stanie WAL i natywnym odzyskiwaniu danych, zamiast obiecywać idealną rekonstrukcję każdego uszkodzonego pliku.
Ustal spójne źródło odzyskiwania
Zatrzymaj aplikację przed zapisem w bazie danych, której dotyczy problem, poprzez normalny proces zamykania lub konserwacji, jeśli to konieczne. Jeśli baza danych musi pozostać aktywna, użyj obsługiwanej spójnej metody tworzenia kopii zapasowych, zamiast kopiować fragmentarycznie aktywnie zmieniający się plik. Zapisz aplikację, ścieżkę bazy danych, środowisko SQLite i dokładny błąd. Następnie zachowaj źródło przed otwarciem go za pomocą narzędzi, które mogą zmienić stan dziennika.
Zachowaj istniejące pasujące przyczepki bazy danych ze źródłem, zwłaszcza plikiem WAL, jeśli jest obecny. Nie łącz bazy danych z jednego okresu z bazą WAL skopiowaną z innego, niepowiązanego stanu. Lepsza jest spójna kopia zapasowa lub migawka magazynu niż zwykła kopia aktywnego pliku. Zachowaj także oddzielną, nietkniętą kopię, aby każdy eksperyment odzyskiwania rozpoczynał się od znanych dowodów, a nie od wyników poprzedniej próby.
Dowolna trasa 1: sprawdź istniejącą spójną kopię zapasową
- Znajdź istniejącą kopię zapasową obsługiwaną przez aplikację lub spójną z SQLite sprzed awarii.
- Przywróć go do osobnego katalogu testowego, a nie do produkcyjnej bazy danych.
- Otwórz go za pomocą odpowiedniej aplikacji lub środowiska SQLite i przeprowadź kontrolę strukturalną.
- Porównaj ważne rekordy i zachowanie aplikacji przed wybraniem ich jako punktu odniesienia odzyskiwania.
Istniejąca kopia zapasowa może być bardziej niezawodna niż ratowanie uszkodzonych stron, ale jej wiek ma znaczenie. Porównaj najnowsze oczekiwane rekordy z czasem przerwy. Następnie zidentyfikuj, których późniejszych transakcji brakuje. Czysta baza danych z wczoraj może być przydatna, ale nie jest wystarczająco aktualna do zamierzonego zadania. Zachowaj uszkodzone źródło i sprawdź, czy nowsze, ważne dane można odzyskać osobno.
Sprawdź rzeczywistą tożsamość kopii zapasowej
Sprawdź oczekiwane tabele i mały zestaw znanych rekordów. Porównaj także dowolną wersję aplikacji lub metadane schematu używane przez oprogramowanie. Plik z odpowiednim rozszerzeniem może należeć do innego profilu lub starszej wersji aplikacji. Nie pozwól, aby aplikacja przeprowadziła migrację jedynej kopii zapasowej przed jej zapisaniem, ponieważ migracja może zmienić strukturę, którą chcesz ocenić.
Jeśli istnieje kilku kandydatów zapasowych, zapisz ich pochodzenie i najważniejsze etapy zawartości. Na przykład zwróć uwagę, czy pojawia się określony zakończony import lub edytowany rekord. Czasy modyfikacji plików pomagają sortować kandydatów, ale nie ustalają kompletności transakcji. Rzeczywista zawartość bazy danych i oczekiwania aplikacji decydują o tym, czy kopia zapasowa jest odpowiednią bazą.
Dowolna trasa 2: zachowaj pasujący stan WAL
- Zachowaj spójny zestaw zawierający bazę danych i istniejące pasujące pliki poboczne.
- Zachowaj nietknięty zestaw źródłowy i utwórz oddzielny zestaw roboczy do kontroli.
- Otwórz zestaw roboczy w odpowiednim środowisku SQLite bez usuwania lub zastępowania jego WAL.
- Sprawdź oczekiwane zatwierdzone rekordy i utwórz nową, spójną kopię zapasową wszelkich użytecznych wyników.
WAL jest częścią trwałego stanu bazy danych, jeśli zawiera odpowiednie transakcje. Oddzielenie go od bazy danych może spowodować utratę zatwierdzonych zmian lub spowodować niespójny wynik. Jednak znalezienie WAL nie oznacza automatycznie, że zawiera brakujące rekordy. Baza danych i WAL muszą należeć do siebie, a wynik nadal wymaga sprawdzenia. Nie dołączaj niepowiązanego pliku WAL tylko dlatego, że jego nazwa bazowa wygląda podobnie.
Nie używaj czyszczenia dziennika jako pierwszej naprawy
Usuwanie przyczepek, wymuszanie punktu kontrolnego lub zmiana trybu dziennika może zmienić przydatne dowody. Zachowaj pierwotny stan przed rozważeniem takich operacji i w razie potrzeby skorzystaj z obsługiwanego procesu aplikacji. Błąd blokady lub zajętości również nie dowodzi uszkodzenia. Przed próbą odbudowania jej zawartości sprawdź, czy inny proces nadal przechowuje bazę danych.
Pracuj nad oddzielnym katalogiem, w którym możesz śledzić, które pliki SQLite zmieniają się podczas otwierania. Następnie porównaj dane logiczne ze stanem oczekiwanym. Jeśli zestaw roboczy stanie się użyteczny, utwórz odpowiednio spójne dane wyjściowe, zamiast kopiować tylko wybrany plik, gdy połączenia pozostaną aktywne. Pozwala to zachować wyraźną granicę między dowodami źródłowymi a zaakceptowaną, odzyskaną bazą danych.
Bezpłatna trasa 3: uruchom natywne odzyskiwanie SQLite na kopii
- Uzyskaj oficjalną powłokę wiersza poleceń SQLite, która udostępnia funkcję .recover.
- Otwórz w powłoce roboczą kopię uszkodzonej bazy danych.
- Bezpośrednio dane wyjściowe .recover do nowego pliku SQL, zachowując oryginalną bazę danych w niezmienionej postaci.
- Wczytaj ten kod SQL do nowej, osobnej bazy danych i zapisz wszystkie zgłoszone błędy.
Aby uzyskać interaktywny przykład, uruchom sqlite3 ze skopiowaną bazą danych o nazwie working.db. Wewnątrz tej powłoki użyj .output recovered.sql, następnie .recover, następnie .output stdout i na koniec .quit. Są to osobne polecenia wprowadzane pojedynczo. Następnie uruchom sqlite3 z nowym miejscem docelowym o nazwie recovered.db i użyj .read recovered.sql. Wybierz nieużywane nazwy wyników, aby wcześniejsza próba odzyskiwania pozostała dostępna do porównania.
Przejrzyj wynik odzyskiwania przed akceptacją
Odzyskiwanie natywne próbuje wyodrębnić użyteczną zawartość z uszkodzonych struktur. Może także przywrócić wcześniej usunięty materiał lub umieścić niepewne zapisy w tabeli rzeczy znalezionych. Dlatego raczej przeglądaj jego dane wyjściowe i błędy, niż traktuj ukończone polecenie jako dowód poprawności. Zachowaj dane wyjściowe SQL i notatki obok odzyskanej bazy danych, aby móc prześledzić, co dostarczył proces odzyskiwania.
W przypadku danych poufnych lub wrażliwych na aplikacje nie importuj wyników odzyskiwania bezpośrednio do działającego serwisu. Przetestuj to osobno, korzystając z reprezentatywnych zapisów i relacji. Ponowne pojawienie się usuniętych wierszy lub zmienionych wartości może mieć znaczenie nawet wtedy, gdy baza danych przejdzie kontrolę strukturalną. Odpowiednia decyzja o akceptacji zależy od znaczenia danych, a nie tylko od tego, czy zapytanie zwróci wyniki.
Bezpłatna trasa 4: selektywnie eksportuj czytelną treść
- Otwórz tylko kopię roboczą za pomocą odpowiedniego narzędzia SQLite.
- Identyfikuj tabele lub zapytania, które pozostają czytelne bez błędów.
- Eksportuj przydatne rekordy z udokumentowanymi definicjami kolumn i odpowiednimi relacjami.
- Zaimportuj je do osobnej bazy danych rekonstrukcji i zatwierdź wynik.
Eksport selektywny może być pomocny, gdy całkowite odzysk powoduje zbyt dużą niepewność lub jeden uszkodzony obszar uniemożliwia normalne użytkowanie. Może jednak pominąć ograniczenia, indeksy, wyzwalacze, widoki lub nieczytelne wiersze. Zachowaj ten zakres wyraźnie. Plik CSV zawierający pewne rekordy pozwala na odzyskanie danych, ale nie zapewnia pełnego przywrócenia oryginalnej bazy danych aplikacji.
Zachowaj typy i relacje
Eksport tekstu może zmienić sposób reprezentowania wartości, szczególnie w przypadku wartości null, pól binarnych, dat i identyfikatorów numerycznych. Zapisz oryginalny schemat i sprawdź zachowanie importu. W stosownych przypadkach porównaj także relacje klucza podstawowego i obcego. Czytelna tabela może wprowadzać w błąd, jeśli jej identyfikatory nie łączą się już z powiązanymi rekordami w innej tabeli.
Na przykład odzyskane załączniki mogą wymagać wierszy metadanych identyfikujących elementy, do których należą. Odzyskiwanie tylko nazw plików załączników może spowodować pozostawienie folderu nieprzypisanych plików. Zachowaj dowody pokrewieństwa i porównaj je ze znanymi zapisami. Jeśli nie możesz nawiązać niezawodnego połączenia, oznacz te elementy jako niepewne, zamiast wymyślać skojarzenia, aby wniosek wyglądał na kompletny.
Przeprowadź kontrolę strukturalną odzyskanej kopii
Użyj PRAGMA integrity_check; w odpowiednim środowisku SQLite w celu oceny spójności strukturalnej odzyskanej bazy danych. Następnie użyj PRAGMA foreign_key_check; gdy istotne są relacje klucza obcego. Zapisz rzeczywiste wyniki i wszelkie błędy. Kontrole te odpowiadają na różne pytania, a pozytywne ich zaliczenie nie oznacza, że obowiązują wszystkie zasady biznesowe lub aplikacyjne.
Dodaj kontrole odpowiadające znaczeniu danych
Porównaj oczekiwaną liczbę tabel, ważne identyfikatory i reprezentatywne wartości rekordów z wiarygodnymi dowodami zewnętrznymi. Testuj także połączenia i przepływy pracy aplikacji, które opierają się na relacjach między tabelami. Baza danych może być wewnętrznie spójna, choć może brakować całego niedawnego importu. I odwrotnie, nieoczekiwana liczba wierszy może odzwierciedlać przywrócony, usunięty materiał, a nie pomyślne przywrócenie zamierzonego bieżącego stanu.
Sprawdź kodowanie tekstu, zawartość binarną i wymagane wartości w próbce obejmującej główne typy danych aplikacji. Następnie sprawdź odpowiednie przypadki graniczne, takie jak najnowsze zapisy sprzed awarii. Dzięki temu akceptacja ma większe znaczenie niż uruchamianie pojedynczego zapytania względem wygodnej tabeli i założenie, że reszta bazy danych zachowuje się w ten sam sposób.
Odróżnij korupcję od niezgodnego środowiska
Aplikacja może odrzucić prawidłową bazę danych, ponieważ oczekuje innego schematu, wymaganego rozszerzenia lub zaszyfrowanego formatu. Przed wybraniem narzędzia do odzyskiwania zapisz dokładne środowisko i błąd. Ogólna powłoka SQLite nie musi koniecznie czytać bazy danych, która wymaga określonej implementacji szyfrowania. Zmiana nazwy pliku lub wielokrotne uruchamianie odzyskiwania nie spowoduje dostarczenia brakującego klucza ani rozszerzenia.
Oddziel migrację aplikacji
Jeśli nowsza aplikacja proponuje migrację, najpierw zachowaj źródło i przetestuj migrację na osobnym kandydacie. Następnie porównaj powstały schemat i ważne zapisy. Migracja może zakończyć się sukcesem, zmieniając zachowanie, dlatego zasługuje na własną kontrolę akceptacji. Nie należy mylić nowo migrowanego pliku z nienaruszoną, odzyskaną historyczną bazą danych.
Sprawdź także zwykłe problemy z dostępem, takie jak uprawnienia, niedostępna pamięć lub inny proces blokujący. Mogą one uniemożliwić otwarcie bez sugerowania uszkodzenia strony. Rozwiąż konkretny problem z dostępem w normalny obsługiwany sposób. Odbudowa prawidłowej bazy danych w celu rozwiązania problemu ze ścieżką lub uprawnieniami dodaje niepotrzebnej niepewności do danych, które mogą już być nienaruszone.
Sprawdzone odzyskiwanie uszkodzonego katalogu lokalnego
Załóżmy, że katalog lokalny zgłasza błąd bazy danych po przerwaniu zapisu. Zachowaj spójny zestaw źródeł i porównaj najpierw najnowszą obsługiwaną kopię zapasową. Sprawdź, czy kopia zapasowa zawiera najnowsze ważne elementy. Jeśli tak się nie stanie, zamiast natychmiastowej wymiany katalogu uruchom odzyskiwanie natywne na osobnej, uszkodzonej kopii i sprawdź odzyskane rekordy.
Uważnie uzgadniaj ważne zapisy
Kopia zapasowa może zapewnić czysty schemat i stabilne starsze rekordy, podczas gdy kopia zapasowa zawiera niektóre najnowsze wpisy. Porównaj identyfikatory i powiązane tabele przed jakimkolwiek połączeniem. Nie dołączaj na ślepo każdego odzyskanego wiersza, ponieważ usunięta lub zduplikowana treść może pojawić się ponownie. Stwórz osobny wynik testu i zapisz, które dane pochodzą z kopii zapasowej, a które z niepewnego odzyskania.
Następnie otwórz wynik w profilu aplikacji testowej i przećwicz reprezentatywne przepływy pracy. Sprawdź wyświetlanie elementu, wyszukiwanie, dostęp do załączników i edycję, jeśli to konieczne. Trzymaj dowody źródłowe i odrzuconych kandydatów oddzielnie. Udany start to tylko jedna część akceptacji; aplikacja musi także poprawnie wykorzystywać odzyskane relacje i treści.
Unikaj destrukcyjnych eksperymentów na jedynym źródle
Nie zaczynaj od VACUUM, przepisania schematu lub poleceń czyszczenia uszkodzonego oryginału. Takie operacje mogą spowodować zmianę stron lub usunięcie informacji, które mogą zostać wykorzystane w kolejnej próbie odzyskania. Zachowaj oryginał i użyj świeżej kopii roboczej dla każdego odrębnego podejścia. Zachowaj dane wyjściowe poleceń i nazwy kandydatów, aby nieudany eksperyment nie stał się niewyjaśnionym nowym punktem odniesienia.
Poznaj ograniczenia odzyskiwania strony
Brakujące lub nadpisane strony mogą spowodować, że niektóre informacje będą trwale niedostępne. Odzyskiwanie natywne może również odzyskać wartości bez wystarczającego kontekstu, aby niezawodnie zidentyfikować oryginalną tabelę. Wskaż te luki, zamiast wypełniać je domysłami. Mniejszy zweryfikowany zbiór danych może być bardziej przydatny niż większy wynik, którego rekordom nie można ufać ani nie można ich poprawnie powiązać.
Jeśli baza danych wspiera ważne decyzje operacyjne, poproś odpowiedzialnego właściciela danych o sprawdzenie kryteriów akceptacji. Kontrole techniczne zapewniają czytelność i spójność, a właściciel może porównać treść z rzeczywistymi zapisami, które reprezentuje. Jest to praktyczny podział prac weryfikacyjnych, a nie powód do twierdzenia, że strukturalnie czysta baza danych musi być dokładna.
Zdefiniuj akceptację na poziomie rekordu przed połączeniem odzyskiwania
Wybierz reprezentatywne rekordy określające, czy odzyskana baza danych zawiera zamierzony stan. Uwzględnij znany starszy rekord, najnowszy rekord i relację obejmującą inną tabelę. Następnie porównaj ich wartości z wiarygodnymi dowodami zastosowania. Zamienia to niejasne twierdzenie o pomyślnym odzyskaniu danych w konkretną kontrolę zawartości i pomaga zidentyfikować przejrzystą bazę danych, w której nadal brakuje ważnych niedawnych transakcji.
Porównaj identyfikatory i wartości razem
Znany identyfikator rekordu nie gwarantuje, że powiązane z nim wartości przetrwają prawidłowo. W stosownych przypadkach sprawdź ważny tekst, pola numeryczne, wartości null i odniesienia binarne. Następnie sprawdź powiązane wiersze. Rekord nadrzędny może przetrwać, gdy jego wiersze podrzędne znikną, a odzyskany wiersz może utracić relację nadającą mu znaczenie. Trzymaj niepewne skojarzenia oddzielnie, zamiast wymyślać linki, które sprawią, że wyświetlacz aplikacji będzie wyglądał na kompletny.
Podczas uzgadniania czystej kopii zapasowej z odzyskanymi ostatnimi wierszami należy udokumentować źródło każdej zaimportowanej grupy. Porównaj klucze przed włożeniem i sprawdź potencjalne duplikaty. Nie zakładaj, że wszystkie rekordy, których nie ma w kopii zapasowej, są ważnymi nowymi rekordami; ratunek może przywrócić wcześniej usuniętą zawartość. Kontrolowane scalanie powinno zachować czystą linię bazową i utworzyć oddzielny wynik testu, który można sprawdzić przed wymianą jakiejkolwiek działającej bazy danych.
Przejrzyj obiekty schematu i wiersze tabeli
Użyteczna baza danych aplikacji może oprócz widocznych rekordów opierać się na indeksach, widokach, wyzwalaczach, ograniczeniach i metadanych. Zinwentaryzuj oczekiwany schemat w znanej kopii zapasowej lub dokumentacji obsługiwanej aplikacji. Następnie porównaj odzyskanego kandydata. Brakujące obiekty schematu mogą powodować błędy lub zmianę zachowania nawet w przypadku pomyślnego wykonania prostego zapytania do tabeli, dlatego przed przetestowaniem aplikacji zanotuj różnice.
Odróżnij brakujący indeks od brakujących danych logicznych
Niektóre uszkodzenia mogą wpływać na struktury dostępu bez niszczenia każdego rekordu, podczas gdy inne powodują usunięcie samej treści. Nie wnioskuj o zakresie na podstawie jednego komunikatu o błędzie. Sprawdź wyniki kontroli natywnej i porównaj czytelne dane na kopii roboczej. Wszelkie działania związane z odbudową powinny mieć jasny cel i zachowane źródło, ponieważ szerokie przepisanie może zmienić dowody bez rozwiązania faktycznego problemu z zastosowaniem.
Sprawdź także metadane aplikacji, które identyfikują wersję schematu lub własność profilu. Technicznie ważna baza danych z innego profilu może być nieodpowiednia, nawet jeśli nazwy jej tabel są zgodne. Zachowaj oczekiwany kontekst aplikacji w rekordzie akceptacji. Pozwala to uniknąć promowania kandydata o czystej strukturalnie, ale semantycznie błędnego tylko dlatego, że otwiera się w ogólnej przeglądarce SQLite.
Ostrożnie interpretuj treści zagubione i znalezione
Funkcja odzyskiwania natywnego może wyodrębnić rekordy, których nie można w sposób pewny powiązać z oryginalną tabelą. Zachowaj te dane wyjściowe, ale nie wstawiaj ich od razu do dowolnej tabeli mającej podobną liczbę kolumn. Porównuj typy, identyfikatory i znaną treść i izolowaj niepewne wiersze. Brakujący kontekst strukturalny może być równie ważny jak same odzyskane wartości.
Rejestruj niepewność w najmniejszym użytecznym zakresie
Możesz zweryfikować jeden odzyskany element, pozostawiając inny nierozwiązany. Zachowaj te decyzje oddzielnie. Na przykład rozpoznawalna treść notatki może być przydatna do odzyskiwania tekstu, nawet jeśli nie można ustalić powiązania z oryginalnym folderem. Oznacz go odpowiednio, zamiast przypisywać do wymyślonej lokalizacji. Pozwala to zachować cenne informacje bez przekształcania niepewności w wprowadzający w błąd stan aplikacji.
Jeżeli właściciel danych może porównać odzyskane dane z wiarygodnymi zapisami, należy przedstawić jasną listę kandydatów i odpowiednie szczegółowe informacje o źródle. Zachowaj nietknięte dane wyjściowe SQL i kopie baz danych jako dowód. Późniejszy przegląd może rozwiązać powiązanie, które jest obecnie niejasne, a zachowanie surowego materiału ocalonego zapobiega sytuacji, w której decyzja o wcześniejszej rekonstrukcji nie stanie się jedyną pozostałą interpretacją.
Przetestuj aplikację w osobnym profilu lub obszarze roboczym
Po sprawdzeniu strukturalnym użyj obsługiwanego środowiska nieprodukcyjnego, aby sprawdzić odzyskaną bazę danych. Przedstawiciel ćwiczeń czyta i edytuje przepływy pracy, a następnie porównuje powstałe rekordy. Spełnia to oczekiwania, których nie może wyrazić ogólne sprawdzenie SQLite, takie jak wymagane metadane lub relacje wymuszone przez logikę aplikacji. Trzymaj zmiany środowiska testowego oddzielnie od zaakceptowanego kandydata do odzyskiwania.
Sprawdź zachowanie po ponownym otwarciu
Zamknij normalnie aplikację testową i otwórz ponownie tego samego kandydata. Następnie ponownie sprawdź ważne zapisy. Niektóre problemy pojawiają się tylko wtedy, gdy aplikacja zapisuje stan, odbudowuje pamięć podręczną lub ponownie ładuje relacje. Pojedynczy udany start jest zatem niekompletnym testem akceptacyjnym. Zapisz wszelkie nowe ostrzeżenia i porównaj stan bazy danych przed podjęciem decyzji, czy kandydat jest gotowy do dalszego użycia.
Na koniec utwórz obsługiwaną, spójną kopię zapasową zaakceptowanego wyniku i przetestuj ją niezależnie. Zachowaj osobno oryginalne uszkodzone źródło, pasujące wózki boczne, dane wyjściowe i notatki odbioru. Jeśli odzyskanie danych pozostaje częściowe, wyraźnie zidentyfikuj brakujące lub niepewne zapisy. Zapewnia to wiarygodną bazę operacyjną, zachowując jednocześnie dowody potrzebne do późniejszej rekonstrukcji lub specjalistycznego dochodzenia.
Odzyskiwanie plików należy oddzielić od akceptacji transakcji
Odzyskana nazwa pliku bazy danych stanowi dane wejściowe do oceny logicznej, a nie stwierdzenie, że każda transakcja przetrwała. Porównaj rzeczywiste rekordy i relacje, które definiują zamierzony stan aplikacji. Następnie zapisz, które testy wypadły pomyślnie, a jakie pozostały luki. To rozróżnienie jest szczególnie przydatne, gdy skanowanie pliku dostarcza kilku kandydatom wiarygodnych dat, ale różnej treści lub niekompletnego kontekstu pomocniczego.
Zachowaj powtarzalne kroki odzyskiwania
Użyj nowej kopii roboczej dla każdego odrębnego podejścia do odzyskiwania i zapisz nazwy wyników. Zachowaj wersję narzędzia i odpowiednie opcje wraz z wynikami. Następnie porównaj kandydatów, korzystając z tych samych kontroli na poziomie rekordów. Dzięki temu badanie jest powtarzalne i zapobiega uzależnieniu widocznej poprawy od nieudokumentowanej zmiany wprowadzonej podczas poprzedniej nieudanej próby.
Jeśli ostatecznie wybierzesz czystą starszą kopię zapasową zamiast większego wyniku odzyskiwania, podaj dlaczego. Zweryfikowane relacje i znana treść mogą być bardziej przydatne niż dodatkowe niepewne wiersze. Zachowaj dane odzyskane osobno do późniejszego przeglądu, zamiast na siłę umieszczać każdą wyodrębnioną wartość w zaakceptowanej bazie danych. Daje to wiarygodny punkt odniesienia, zachowując jednocześnie potencjalnie cenne informacje, które nadal wymagają interpretacji.
Odzyskiwanie usuniętych plików może pomóc w danych SQLite
PandaOffice Drecov ma zastosowanie, gdy zapisana baza danych, pasująca do istniejącego pliku dziennika lub spójna kopia zapasowa została usunięta z dostępnej pamięci. Nie zastępuje narzędzi odzyskiwania logicznego SQLite ani nie odtwarza nadpisanych transakcji. Zmniejsz także zapisy w dotkniętym magazynie. Jeśli samo urządzenie zgłasza powtarzające się błędy odczytu, oceń ten stan przed uruchomieniem rutynowego skanowania w poszukiwaniu usuniętych plików.
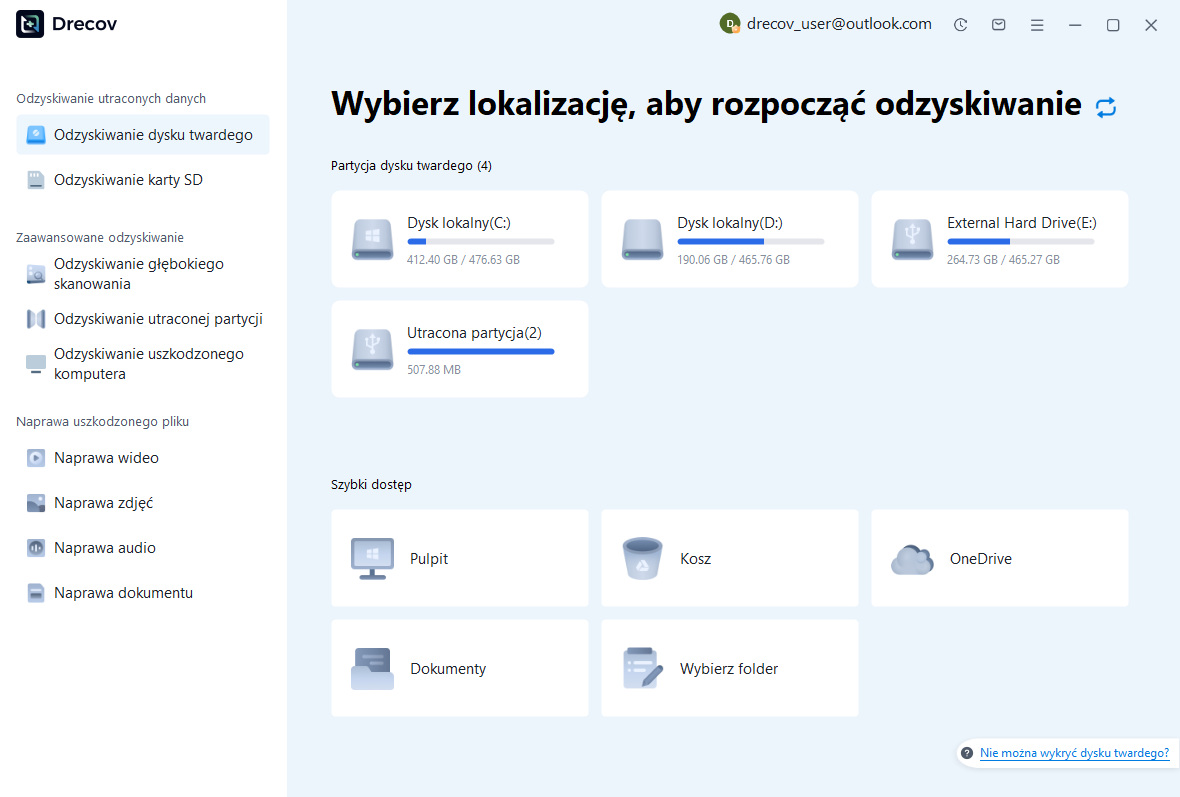
Krok 1: zidentyfikuj oryginalne miejsce przechowywania bazy danych
Wybierz dysk lub partycję, na której znajdowała się baza danych aplikacji, oraz jej rzeczywistą lokalizację kopii zapasowej. Zapisz oryginalną nazwę bazową i wszelkie towarzyszące jej dodatkowe nazwy. Zachowaj dane wyjściowe odzyskiwania w innym zdrowym magazynie. Unikaj uruchamiania aplikacji w lokalizacji, której dotyczy problem, jedynie w celu wygenerowania kolejnego błędu, ponieważ może to spowodować utworzenie nowych plików lub zmianę istniejącego stanu dziennika.
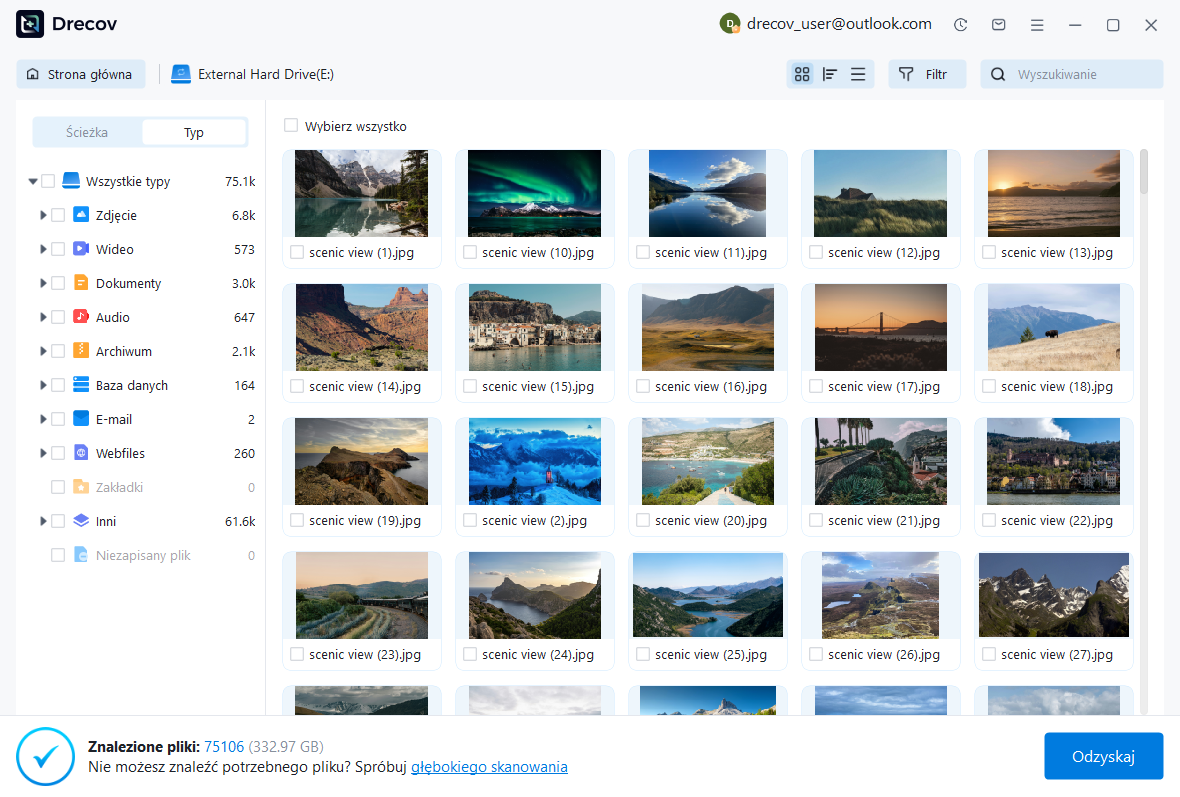
Krok 2: zbierz spójne kandydaci do bazy danych
Przejrzyj dostępne nazwy, ścieżki, rozmiary i daty bazy danych i powiązanych plików. Zachowaj kilku prawdopodobnych kandydatów bez łączenia niepowiązanych wersji. Skanowanie nie może ustalić spójności transakcyjnej na podstawie samej nazwy pliku. Zachowaj szczegółowe informacje o źródle i traktuj odzyskane zestawy baz danych i przyczepek pomocniczych jako kandydatów, którzy wymagają późniejszej walidacji SQLite i aplikacji.
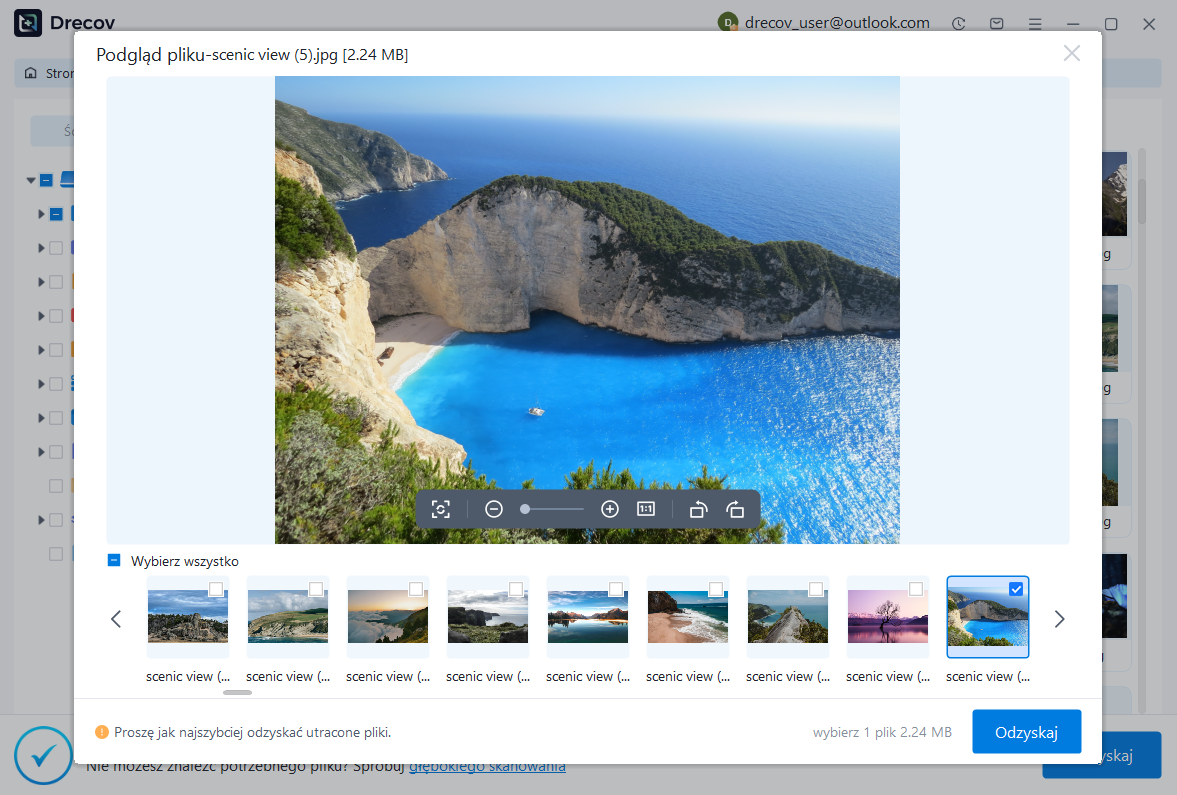
Krok 3: odzyskaj w innym miejscu i sprawdź zawartość logiczną
Przywróć wybrane pliki do osobnego miejsca docelowego, zachowaj nietknięty odzyskany zestaw i sprawdź inną kopię roboczą. Porównaj istniejące kopie zapasowe, przeprowadź odpowiednie kontrole natywne lub odzyskiwanie oraz przetestuj ważne rekordy i relacje. Nie zwracaj niezweryfikowanego odzyskiwania bezpośrednio do serwisu. Pełna nazwa pliku i pomyślne przywrócenie pliku nie dowodzą, że zamierzone transakcje przetrwały.
Udokumentuj zaakceptowaną bazę danych i pozostałą niepewność
Zapisz kandydata źródłowego, narzędzia, polecenia, błędy, kontrole i testy aplikacji użyte do zaakceptowania wyniku. Przechowuj odzyskaną bazę danych oddzielnie od danych wyjściowych SQL i oryginalnych dowodów. Następnie utwórz obsługiwaną spójną kopię zapasową zweryfikowanego stanu. Dzięki temu następne zadanie konserwacyjne będzie stanowić niezawodną podstawę zamiast zbioru niejednoznacznych kopii bazy danych.
Testuj przyszłe kopie zapasowe jako rzeczywiste przywracanie
Użyj przykładu nieprodukcyjnego, aby przetestować procedurę tworzenia kopii zapasowych i przywracania aplikacji. Sprawdź, czy dane wyjściowe otwierają się niezależnie i zawierają oczekiwane ostatnie rekordy. Udokumentuj także, w jaki sposób aplikacja korzysta z WAL i gdzie powinna znajdować się jej kopia zapasowa. Praktyczny test przywracania dostarcza dowodów na to, że ochrona działa, podczas gdy zwykłe kopiowanie widocznej nazwy pliku bazy danych może przeoczyć część jego trwałego stanu.
Jeżeli niektórych zapisów brakuje lub są one niepewne, należy je wyraźnie wymienić. Częściowe odzyskanie może nadal umożliwiać odzyskanie cennych informacji, ale nie powinno stać się bezwarunkowym roszczeniem o całkowite przywrócenie. Jasne limity pomogą Ci zdecydować, czy rekonstruować na podstawie innych wiarygodnych zapisów, zachować wynik w celach informacyjnych, czy też kontynuować specjalistyczne badania.
Powiązane zasoby odzyskiwania
Zapoznaj się z odpowiednimi opcjami odzyskiwania: Odzyskiwanie dysku twardego, Odzyskiwanie zewnętrznego dysku twardego.
Aby zapoznać się z innym przypadkiem odzyskiwania środków i jego praktycznymi kontrolami, przeczytaj powiązany przewodnik odzyskiwania.
Sprawdź wskazówki dostawcy dotyczące zainstalowanej wersji: oficjalna dokumentacja odzyskiwania 1, oficjalna dokumentacja odzyskiwania 2, oficjalna dokumentacja odzyskiwania 3, oficjalna dokumentacja odzyskiwania 4.





