







Odzyskaj projekt OpenRefine, a nie tylko jego ostatni eksport
Aby odzyskać projekty OpenRefine, zachowaj rzeczywisty obszar roboczy i istniejące archiwa projektów przed ponownym zaimportowaniem pliku CSV. Oczyszczony eksport danych i natywne archiwum projektu zawierają różne informacje. Określ zatem, czy potrzebujesz aktualnej tabeli, wcześniejszych stanów danych, zarejestrowanych operacji, informacji o uzgodnieniu, czy po prostu widoku, który zniknął z przeglądarki.
Historia OpenRefine może zachować przydatne transformacje między sesjami, gdy dane projektu przetrwają. Archiwum może zachować kamień milowy projektu, a zapisana receptura operacji może pomóc w kontrolowanej rekonstrukcji z oryginalnych danych wejściowych. Trasy te mają różne wymagania wstępne. Sam plik CSV nie odtwarza automatycznie każdego wcześniejszego stanu i decyzji z brakującego projektu.
Zapisz stan brakujących danych
Zapisz tytuł projektu, lokalizację obszaru roboczego, znaną liczbę wierszy i wyróżniającą transformację. Zidentyfikuj także oryginalną wersję wejściową. Te szczegóły pomagają porównać projekty o podobnych nazwach. Tabela może wyglądać znajomo, odzwierciedlając inny filtr, wcześniejszy etap czyszczenia lub zmieniony zbiór danych źródłowych, dlatego należy sprawdzać konkretną zawartość, a nie sam tytuł karty przeglądarki.
Jeśli projekt pozostaje dostępny, przed eksperymentowaniem z historią wyeksportuj odpowiednie lokalne archiwum projektu. Zachowaj oczyszczony eksport danych osobno, jeśli jest to przydatne. Jeśli jest to praktyczne, zatrzymaj także aplikację w obsługiwanym procesie przed skopiowaniem danych obszaru roboczego. Stabilny zestaw źródeł zapewnia punkt odniesienia podczas sprawdzania starszych stanów lub importowania kandydatów do archiwów.
Dowolna trasa 1: ponownie podłącz prawidłowy istniejący obszar roboczy
- Zidentyfikuj lokalizację obszaru roboczego używaną przez oryginalną instalację OpenRefine.
- Zachowaj ten obszar roboczy przed przystąpieniem do rozwiązywania problemów z konfiguracją lub ponowną instalacją.
- Uruchom aplikację z odpowiednim istniejącym obszarem roboczym poprzez konfigurację obsługiwaną dla Twojego środowiska.
- Otwórz zamierzony projekt i porównaj jego dane i zapisaną historię.
Projekt może wydawać się brakujący, gdy aplikacja korzysta z innego obszaru roboczego lub kontekstu użytkownika. Poprawienie tej lokalizacji przywraca dostęp do treści, które nadal istnieją. Nie pobiera usuniętego katalogu projektu. Rozróżnij także pamięć aplikacji lokalnej od interfejsu przeglądarki: wyczyszczenie widoku przeglądarki i utrata danych z obszaru roboczego to różne zdarzenia o różnych konsekwencjach.
Sprawdź razem listę projektów i ich zawartość
Porównaj charakterystyczną kolumnę, znany rekord i etap historii w projekcie kandydującym. Następnie sprawdź liczbę wierszy za pomocą zrozumiałych filtrów. Podobny tytuł projektu może reprezentować inny import lub kopię wcześniejszej współpracy. Zachowaj oba do czasu ustalenia, które źródło zawiera zamierzone przekształcenia i rewizję danych.
Nie łącz ręcznie wewnętrznych elementów katalogu projektu w ramach pierwszego kroku odzyskiwania. Obszar roboczy zawiera relacje, którymi aplikacja ma zarządzać. Zachowaj go i preferuj obsługiwany import projektu lub izolowany skopiowany obszar roboczy do testowania. Dzięki temu przydatny kandydat nie ulegnie uszkodzeniu w wyniku zaimprowizowanego połączenia systemu plików.
Dowolna trasa 2: zaimportuj istniejące archiwum projektu
- Znajdź wcześniej wyeksportowane archiwum projektu OpenRefine z odpowiedniego kamienia milowego.
- Zachowaj archiwum i użyj opcji Importuj projekt z ekranu głównego aplikacji.
- Nadaj zaimportowanemu kandydatowi odrębną nazwę odzyskiwania.
- Porównaj jego tabelę, historię cofania/ponawiania i odpowiednie informacje o uzgodnieniu.
Natywne archiwum może zachować dane i historię projektu, które pomija zwykły eksport danych. Przedstawia jednak moment, w którym powstał. Sprawdź charakterystyczną niedawną transformację, zanim założysz, że zawiera ona najnowsze czyszczenie. Trzymaj archiwum oddzielnie od zaimportowanego projektu roboczego, aby późniejsze eksperymenty nie mogły stać się jedyną zachowaną kopią tego kamienia milowego.
Odróżnij historię od jej aktualnych aspektów
Archiwum przechowuje ważne informacje o projekcie, ale bieżące widoki i zastosowane aspekty mogą wymagać osobnej rekonstrukcji. Projekt może zatem zawierać zamierzone dane, a po imporcie wyglądać inaczej. Zanim stwierdzisz, że czyszczenie zniknęło, sprawdź rzeczywiste wartości i historię. Celowo odtwórz niezbędny widok i zapisz dowolne wyrażenie, od którego zależy widok.
Jeśli zaimportowany projekt zawiera wyniki uzgadniania, sprawdź, czy odpowiednia usługa jest dostępna w nowym środowisku. Przetrwanie identyfikatorów i możliwość dalszego pojednania to osobne kwestie. Zachowaj zaimportowane informacje przed odświeżeniem usług lub zastosowaniem nowych sugestii, ponieważ nowa operacja może zmienić stan danych, który chciałeś ocenić.
Dowolna trasa 3: sprawdź pozostały stan Cofnij/Ponów
- Zachowaj bieżący projekt jako archiwum przed zmianą pozycji historycznej.
- Otwórz opcję Cofnij/Ponów i zidentyfikuj odpowiednią transformację lub wcześniejszy kamień milowy (Undo/Redo).
- Sprawdź stan użyteczny bez odrzucania zachowanej bieżącej wersji.
- Przed kontynuowaniem czyszczenia wyeksportuj lub zarchiwizuj zaakceptowane odzyskiwanie oddzielnie.
Zapisana historia może pomóc cofnąć niechcianą transformację, gdy projekt przetrwa. Nie tworzy brakującego projektu źródłowego ani nie przywraca operacji, które nigdy nie dotarły do pamięci trwałej. Porównaj także rzeczywistą tabelę po wybraniu stanu historycznego. Etykieta kroku może podsumowywać operację bez ujawniania każdej wartości, której to dotyczy, dlatego konieczna jest kontrola zawartości.
Zachowaj przydatne późniejsze zmiany
Wcześniejszy stan może przywrócić usunięte wiersze bez poprawek późniejszych. Zachowaj oba etapy i określ, które zmiany wymagają celowego ponownego zastosowania. Nie przyjmuj po prostu najstarszej, kompletnie wyglądającej tabeli, jeśli odrzuca ona zweryfikowaną pracę. Kontrolowana rekonstrukcja może zachować użyteczną historię, jednocześnie ujawniając pozostałe decyzje dotyczące transformacji.
Dla każdego zaakceptowanego stanu porównaj reprezentatywne identyfikatory, liczbę wierszy i kluczowe kolumny. Następnie sprawdź każdy znany przypadek brzegowy, taki jak pusta wartość lub komórka wielowartościowa. Kontrole te łączą operację historii ze znaczeniem danych, które należy zachować, zamiast traktować zakończone wycofanie jako dowód poprawności.
Dowolna trasa 4: ponownie zastosuj zapisaną recepturę operacji
- Zachowaj oryginalny wejściowy zbiór danych i określ jego dokładną wersję oraz ustawienia importu.
- Utwórz nowy projekt odzyskiwania na podstawie kopii tych danych wejściowych.
- Przejrzyj istniejącą zapisaną recepturę operacji i zastosuj odpowiednie operacje poprzez opcję Cofnij/Ponów.
- Porównaj dane pośrednie i końcowe, dokumentując operacje, których receptura nie powiela.
Receptura operacji jest pomocą w rekonstrukcji, a nie całkowitym substytutem natywnego archiwum projektu. Może to zależeć od nazw kolumn, opcji importu i pierwotnego stanu danych. Niektóre prace interaktywne mogą wymagać osobnej uwagi. Dlatego sprawdź przepis i przetestuj jego wyniki, zamiast zakładać, że odtworzy stary projekt z dowolnego pliku CSV o podobnej strukturze.
Porównaj zależności przed zastosowaniem operacji
Sprawdź nazwy kolumn, typy, separatory i strukturę rekordów względem oryginalnego importu. Przepis odnoszący się do niewłaściwej kolumny może zakończyć się niepowodzeniem lub dać wiarygodny, ale nieprawidłowy wynik. Zachowaj także dane wejściowe, zamiast je edytować, aby uruchomić przepis. Wszelkie niezbędne adaptacje powinny być udokumentowaną decyzją o rekonstrukcji w ramach nowego projektu rewitalizacji.
Sprawdź znaczące punkty kontrolne po większych transformacjach. Na przykład porównaj liczbę wierszy po usunięciu, znane identyfikatory po podziale i reprezentatywne wartości po normalizacji. Komunikat o pomyślnej operacji potwierdza jedynie, że aplikacja coś wykonała. Kontrola treści pokazuje, czy odtworzono zamierzone oczyszczenie historii.
Odzyskaj po wyczyszczonym eksporcie danych z realistycznymi limitami
Istniejący plik CSV, arkusz kalkulacyjny lub inny eksport danych może zachować bieżącą tabelę w kamieniu milowym eksportu. Zaimportuj kopię do nowego projektu i sprawdź ją, ale nie zakładaj, że powróciła oryginalna historia. Eksport może pominąć wcześniejsze wartości, usunięte wiersze lub kontekst uzgodnienia. Oznacz wynik jako odzyskany zbiór danych z ograniczoną historią projektu.
Określ, który stan reprezentuje eksport
Porównaj znane rekordy, nazwy kolumn i charakterystyczną transformację, która motywowała do powrotu do zdrowia. Następnie sprawdź liczbę wierszy ze zrozumieniem filtrów eksportu. Plik może być kompletny dla wybranego widoku, pomijając rekordy spoza tego wyboru. Eksport i wszelkie archiwum projektu przechowuj oddzielnie do czasu ustalenia ich rzeczywistego zakresu.
Jeśli przetrwa tylko częściowy eksport, zachowaj go jako użyteczną treść i zidentyfikuj brakujący zakres. Resztę możesz zrekonstruować na podstawie oryginalnych danych wejściowych lub wiarygodnych źródeł, ale jest to praca z nowymi danymi. Rejestruj te źródła i decyzje, zamiast przedstawiać łączny wynik jako bezpośrednie przywrócenie pierwotnego projektu.
Zdiagnozuj brakujące wiersze przed założeniem usunięcia
Sprawdź aktywne aspekty, filtry tekstu, tryb nagrywania i wyświetlaną liczbę. Widok filtrowany może ukryć wiersze, które pozostają w projekcie. Wyczyść lub dostosuj odpowiednie kontrolki widoku w kontekście roboczym i porównaj znane identyfikatory. I odwrotnie, rzeczywiście usunięte wiersze wymagają historii lub innego źródła, a nie powtarzalnych zmian w wyświetlaczu przeglądarki.
Zachowaj jasne koncepcje wierszy i rekordów
Projekt może organizować informacje w taki sposób, że jeden rekord logiczny obejmuje kilka wierszy. Porównaj zamierzoną strukturę przed zaakceptowaniem różnicy w zliczeniu jako utraty danych. Następnie sprawdź reprezentatywne zapisy i powiązane z nimi wartości. Odzyskana tabela z oczekiwaną łączną liczbą wierszy może nadal zawierać przerwane grupowanie lub brakować relacji, które mają znaczenie dla późniejszych przekształceń.
Jeśli odświeżenie przeglądarki zmienia tylko widoczne aspekty, sprawdź zapisane dane projektu przed odbudowaniem wszystkiego. Stan widoku i stan transformacji mają różne role w trwałości. Odzyskanie widoku może być niewielkim zadaniem interfejsu, natomiast odzyskanie utraconej transformacji wymaga historii lub dowodów archiwalnych. Oddzielenie tych ról pomaga uniknąć niepotrzebnej rekonstrukcji.
Przejrzyj informacje o uzgodnieniu po odzyskaniu
Sprawdź zachowane identyfikatory, dopasowania i orzeczenia pod kątem reprezentatywnych zapisów. Następnie potwierdź zamierzoną usługę pojednania i jej dostępność. Zaimportowany projekt może zachować wyniki, wymagając jednocześnie skonfigurowania środowiska, aby kontynuować pracę. Nie odświeżaj ani nie zastępuj istniejących dopasowań przed zachowaniem źródła i zrozumieniem, co może zmienić nowa reakcja usługi.
Trzymaj mecze zweryfikowane i niepewne oddzielnie
Odzyskany identyfikator jest użyteczny tylko wtedy, gdy należy do zamierzonego podmiotu i źródła. Porównaj znane przykłady i przypadki niejednoznaczne. Jeśli rekonstruujesz mecz ręcznie, zapisz tę decyzję, zamiast traktować ją jako przywróconą historię. Ułatwia to późniejszy przegląd i zapobiega cichemu wprowadzaniu niepewnego powiązania do zaakceptowanego zbioru danych.
Sprawdź także kolumny pochodzące z uzgadniania lub wyszukiwań zewnętrznych. Ich wartości mogą odzwierciedlać czas pierwotnego żądania. Powtarzanie wyszukiwania może spowodować wygenerowanie nowszych informacji, co stanowi aktualizację danych, a nie odtworzenie danych historycznych. Zachowaj oryginalny wynik i świadomie zdecyduj, czy zadanie wymaga starego stanu, czy odświeżonego zbioru danych.
Skuteczne odzyskiwanie po niechcianym etapie czyszczenia
Załóżmy, że transformacja usuwa przydatne wiersze i następuje późniejsza korekta. Zachowaj bieżące archiwum projektu, sprawdź opcję Cofnij/Ponów i zlokalizuj stan przed usunięciem. Porównaj znane identyfikatory, aby potwierdzić, że wiersze zwracają. Następnie zidentyfikuj późniejsze poprawki, których nadal potrzebujesz, zamiast akceptować wycofanie jako kompletne rozwiązanie końcowe.
Zrekonstruuj w przejrzysty sposób przyjętą sekwencję
Skorzystaj z zachowanych danych wejściowych, przydatnej historii i sprawdzonych operacji, aby w razie potrzeby utworzyć oddzielny projekt odzyskiwania. Porównaj liczby pośrednie i wartości reprezentatywne po każdym głównym etapie. Zapisz każdą podjętą decyzję, której przepis nie może odtworzyć. Daje to innemu analitykowi jasny obraz wyniku zamiast niewyjaśnionej tabeli, która jedynie przypomina stary eksport.
Na koniec zarchiwizuj zaakceptowany projekt i osobno wyeksportuj zamierzony, oczyszczony zbiór danych. Otwórz ponownie lub ponownie zaimportuj kopię testową i ponownie porównaj charakterystyczną transformację. Sprawdza to zarówno kontynuację prac w ramach projektu, jak i dane dostarczane bezpośrednio, które zawierają różne informacje i powinny pozostać wyraźnie zidentyfikowane.
Porównaj odzyskiwanie OpenRefine ze znanym kamieniem milowym danych
Wybierz kilka rekordów ustalających zamierzony stan czyszczenia, w tym jeden zwykły rekord i jeden trudny przypadek. Zapisz oczekiwane wartości, strukturę wierszy lub rekordów oraz odpowiednią transformację. Następnie sprawdź te przykłady u każdego kandydata do projektu. Tabela z właściwymi nagłówkami i całkowitą liczbą może nadal zawierać starszą decyzję normalizacyjną lub zerwaną relację, więc porównanie na poziomie zawartości pozostaje konieczne nawet po pomyślnym zaimportowaniu.
Przed ponownym odtwarzaniem sprawdź oryginalne dane wejściowe
Zidentyfikuj dokładną wersję zbioru danych i opcje importu zastosowane w oryginalnym projekcie. Porównaj separatory, kodowanie, nagłówki, nazwy kolumn i dowolne grupowanie rekordów, które ma wpływ na późniejsze operacje. Zapisany przepis można uruchomić w odniesieniu do podobnego pliku, uzyskując inny wynik. Zachowaj wprowadzone dane i udokumentuj niezbędne zmiany, zamiast je dowolnie edytować, dopóki przepis nie zadziała. Dzięki temu rekonstrukcja jest oddzielona od dowodów pochodzących z analizy historycznej.
W przypadku importu wielu plików sprawdź identyfikację źródła i kolejność tam, gdzie jest to istotne. Odzyskiwanie może obejmować te same rekordy, zmieniając jednocześnie kontekst, na którym opierały się późniejsze operacje. Porównaj reprezentatywne identyfikatory ze wszystkich źródeł i zachowaj informacje o pochodzeniu. Pomaga to wykryć prawdopodobne, ale nieprawidłowe scalanie i zapobiega ukryciu przez czysty eksport końcowy niepewności co do tego, skąd pochodzą odzyskane wiersze.
Używaj historii jako źródła stanu danych, a nie listy etykiet
Wpis historii podsumowuje operację, ale tabela w tym momencie pokazuje jej rzeczywisty efekt. Sprawdź odpowiednie wartości i liczniki przed i po kroku kandydującym. Następnie, jeśli to konieczne, zachowaj przydatne stany oddzielnie. Daje to kontrolowany sposób na odwrócenie niechcianej transformacji, zachowując jednocześnie dowody ważnej późniejszej pracy, którą być może trzeba będzie ponownie zastosować.
Uzgodnij przywrócone wiersze z późniejszymi poprawkami
Załóżmy, że wycofanie przywraca usunięte rekordy, ale także odrzuca późniejszą korektę pisowni. Zachowaj bieżący stan i użyteczny wcześniejszy stan, a następnie określ rzeczywisty zakres poprawki. Zastosuj ponownie tylko zweryfikowaną pracę w nowym projekcie odzyskiwania. Nie dołączaj na ślepo każdego starego wiersza, ponieważ w przypadku niektórych rekordów usunięcie mogło być prawidłowe. Porównaj znane identyfikatory i udokumentuj decyzję odróżniającą celowe wykluczenia od przypadkowo utraconych danych.
Sprawdź także przekształcenia, które zmieniły strukturę, takie jak dzielenie komórek lub kolumn. Przywrócona wartość może być poprawna, choć pojawia się w innym kontekście wiersza lub rekordu. Porównaj relację, jakiej oczekuje następna operacja. Ta kontrola strukturalna ma znaczenie, gdy przepis historii zależy od poprzedniego utworzenia lub grupowania kolumn, i zapewnia mocniejszy dowód niż zwykłe potwierdzenie, że brakujący tekst jest widoczny gdzieś w tabeli.
Oceń przepis operacji zgodnie z jego zależnościami
Przejrzyj przepis przed jego zastosowaniem i zidentyfikuj kolumny, wyrażenia i założenia wejściowe, których używa. Następnie przetestuj znaczące punkty kontrolne w oddzielnym projekcie. Niektóre zarejestrowane operacje mogą nie odtwarzać każdej interaktywnej decyzji lub reakcji zewnętrznej. Zachowaj wyraźnie te granice. Przepis jest potężną pomocą w rekonstrukcji, ale pomyślne zastosowanie nie jest dowodem na to, że odtwarza oryginalną historię projektu na podstawie dowolnych podobnych danych wejściowych.
Porównaj wartości pośrednie, a nie tylko plik końcowy
Po poważnej transformacji sprawdź reprezentatywny rekord, liczbę i wszelkie istotne przypadki brzegowe. Pomaga to zlokalizować miejsce, w którym rekonstrukcja zaczyna się różnić. Ostateczny eksport może wyglądać znajomo, podczas gdy wcześniejsza normalizacja zmieniła podstawowe dane. Kontrole pośrednie umożliwiają sprawdzenie odzyskania i zmniejszają pokusę kosmetycznego poprawiania wyników bez zrozumienia przyczyny różnicy.
W przypadku wyrażeń skopiowanych z notatek lub starszej receptury dokładnie sprawdź dosłowne nazwy kolumn i separatory. Niewielka zmiana w tłumaczeniu lub transkrypcji może zmienić znaczenie. Zachowaj oryginalny przepis i zapisz wszelkie dostosowane wyrażenia w notatce rekonstrukcji. Następnie porównaj jego rzeczywisty wpływ na znane zapisy. Łączy to operację techniczną z zamierzoną decyzją dotyczącą czyszczenia danych i powstrzymuje późniejszych recenzentów od traktowania nowej adaptacji jako odzyskanego kodu historycznego.
Odróżnij archiwa projektów od zwykłych eksportów danych
Natywne archiwum może zachować dane i historię, podczas gdy zwykły eksport może zachować wybrany stan tabeli przy znacznie mniejszym kontekście projektu. Zachowaj oba, jeśli są dostępne, i porównaj kamień milowy, jaki reprezentuje każdy z nich. Czysty plik CSV może wspierać natychmiastowe dalsze prace bez przywracania wcześniejszych wartości lub ocen uzgadniających. Należy określić ten zakres przed przyjęciem go jako projektu zastępczego.
Sprawdź wybrany widok eksportu
Określ, czy filtry lub aspekty ograniczały eksportowane dane. Następnie porównaj znane identyfikatory uwzględnione i wykluczone. Plik może być kompletny dla wybranego widoku z pominięciem rekordów istotnych dla całego projektu. Nie wnioskuj o odzyskaniu pełnego projektu na podstawie znanego nagłówka i wiarygodnej liczby wierszy. Zachowaj rolę eksportu i poszukaj natywnego archiwum lub oryginalnych danych wejściowych dla brakującego kontekstu.
Jeśli rekonstruujesz na podstawie częściowego eksportu i danych oryginalnych, zapisz, które kolumny i rekordy pochodzą z każdego źródła. Porównaj nakładające się informacje przed połączeniem. Zapobiega to łączeniu starych i nowych wartości bez jasnej podstawy. Mniejszy zweryfikowany zbiór danych może być bardziej przydatny niż większa tabela, której pochodzenie i stan transformacji są niepewne.
Odzyskaj pracę pojednawczą bez jej cichego odświeżania
Sprawdź zachowane identyfikatory i orzeczenia dotyczące reprezentatywnych rejestrów, w tym spraw niejednoznacznych. Następnie zidentyfikuj usługę uzgadniania i konfigurację środowiska wymaganą do kontynuowania. Powtarzanie wyszukiwania zewnętrznego może zwrócić nowsze informacje, które mogą być przydatne, ale stanowią aktualizację danych, a nie odtworzenie danych historycznych. Zachowaj istniejący stan przed przetestowaniem odświeżonych wyników.
Potwierdzone i zrekonstruowane mecze przechowuj oddzielnie
Rozpoznawalna nazwa podmiotu nie dowodzi, że odzyskany identyfikator wskazuje na zamierzony podmiot. Porównaj rzeczywisty mecz i informacje uzupełniające. Jeśli w źródle nie ma oryginalnego wyroku, zapisz nowo wybrane dopasowanie jako rekonstrukcję. Ułatwia to przeglądanie zaakceptowanego zbioru danych i zapobiega zyskaniu autorytetu przez niepewne powiązanie tylko dlatego, że pojawia się w odzyskanym projekcie.
Porównuj także kolumny pochodzące z zewnętrznych wyszukiwań lub transformacji po uzgodnieniu. Mogą one zależeć zarówno od dopasowanego podmiotu, jak i czasu żądania. Zachowaj te wartości i świadomie decyduj, czy zadanie wymaga stanu historycznego, czy bieżącego odświeżenia. Wyraźne oddzielenie pozwala uniknąć stosowania nowoczesnej odpowiedzi jako nieuzasadnionego dowodu na temat tego, co zawierał stary projekt.
Przetestuj zaakceptowane archiwum jako przywracanie prawdziwego projektu
Wyeksportuj natywne archiwum z zaakceptowanego odzyskiwania, a następnie zaimportuj kopię testową z odrębną nazwą. Porównaj ponownie znane zapisy, kamienie milowe w historii i istotne informacje dotyczące uzgodnienia. Sprawdź także, które widoki wymagają osobnego wypoczynku. Ten praktyczny test sprawdza, co faktycznie zapewnia dana metoda konserwacji, i pomaga zapobiec sytuacji, w której eksport samych danych stanie się zakładanym kompletnym archiwum prac analitycznych.
Przekaż następnemu analitykowi zwięzły zapis źródłowy
Zapisz kandydata do obszaru roboczego lub archiwum, wersję danych wejściowych, zrekonstruowane operacje i określone nierozwiązane luki. Następnie zachowaj zaakceptowane archiwum natywne i zamierzony oczyszczony eksport powiązane z tym samym kamieniem milowym. Inny analityk może wykorzystać te dane, rozumiejąc ich historię i ograniczenia. Jeżeli jedna transformacja pozostaje niepewna, należy to wyraźnie określić. Projekt w większości odzyskany jest cenny, gdy zachowane są jego dowody, a pozostałe decyzje można zweryfikować.
Zachowaj możliwość zidentyfikowania odzyskanej tabeli i jej historii
Zapisz zaakceptowane archiwum natywne i zamierzony eksport danych ze wspólnym opisem kamieni milowych. Następnie porównaj znany rekord i transformację po zaimportowaniu kopii testowej. Weryfikuje to, czy archiwum obsługuje ciągłą pracę nad projektem, podczas gdy eksport dostarcza bezpośredni dalszy zbiór danych. Podczas przekazania władzy powinny pozostać jasne ich różne role.
Zapisz nierozwiązaną transformację jako konkretne pytanie
Jeśli zamierzony parametr jednej operacji jest niepewny, zachowaj alternatywy i określ kolumny lub rekordy, których to dotyczy. Nadal możesz odzyskać większość projektu bez cichego wybierania wygodnej wartości. Konkretna luka daje innemu analitykowi możliwą do sprawdzenia decyzję, a nie niewyjaśnioną różnicę ukrytą w stole finałowym.
Przed rozpoczęciem nowego czyszczenia należy osobno zachować kamień milowy stabilnego odzyskiwania. Późniejsze przekształcenia można wówczas odróżnić od restauracji historycznej, a nowo odnalezione archiwum można merytorycznie porównać. Granica ta chroni zarówno odzyskane dowody, jak i ważne nowe prace analityczne, przed staniem się niejednoznaczną mieszaniną poprawek.
Kiedy odzyskiwanie pamięci może pomóc projektom OpenRefine
PandaOffice Drecov może pomóc w odzyskaniu usuniętych zapisanych archiwów projektów, plików obszaru roboczego, oryginalnych danych wejściowych lub wcześniejszych eksportów w czytelnej pamięci. Nie może odtworzyć transformacji, która nigdy nie dotarła na dysk, ani nie może wywnioskować całej historii z końcowego pliku CSV. Użyj najpierw zachowanych obszarów roboczych, archiwów i historii, a następnie ogranicz zapisy do lokalizacji, której dotyczy problem, podczas sprawdzania usuniętych plików.
Krok 1: zidentyfikuj rzeczywisty obszar roboczy lub lokalizację archiwum
Wybierz dysk lub partycję, na której znajdował się lokalny obszar roboczy, archiwum projektu lub oryginalne dane wejściowe. Zapisz komponent źródłowy każdego celu wyszukiwania. Zachowaj dane wyjściowe odzyskiwania w innym zdrowym magazynie. Jeśli źródło wielokrotnie rozłącza się lub zgłasza błędy odczytu sprzętu, oceń ten stan przed przystąpieniem do rutynowego skanowania w celu odzyskania oprogramowania.
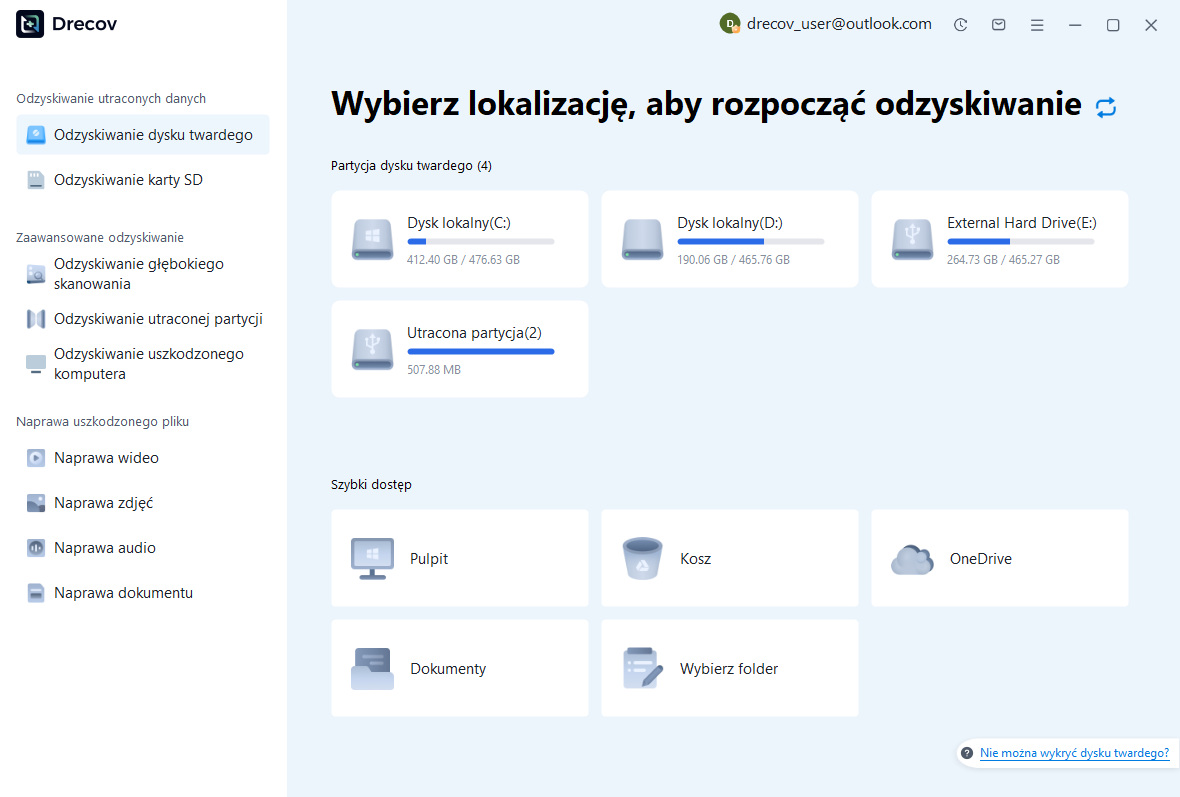
Krok 2: porównaj kandydatów do projektów i zbiorów danych
Przejrzyj dostępne ścieżki, nazwy, rozmiary, daty i obsługiwane podglądy. Zachowaj wiarygodne archiwa i potencjalne obszary robocze bez łączenia niepowiązanych wersji. Rozpoznawalny nagłówek CSV nie potwierdza, że historia projektu przetrwała. Zachowaj przydatne alternatywy i oceń ich tabelę, operacje i kontekst w OpenRefine po odzyskaniu.
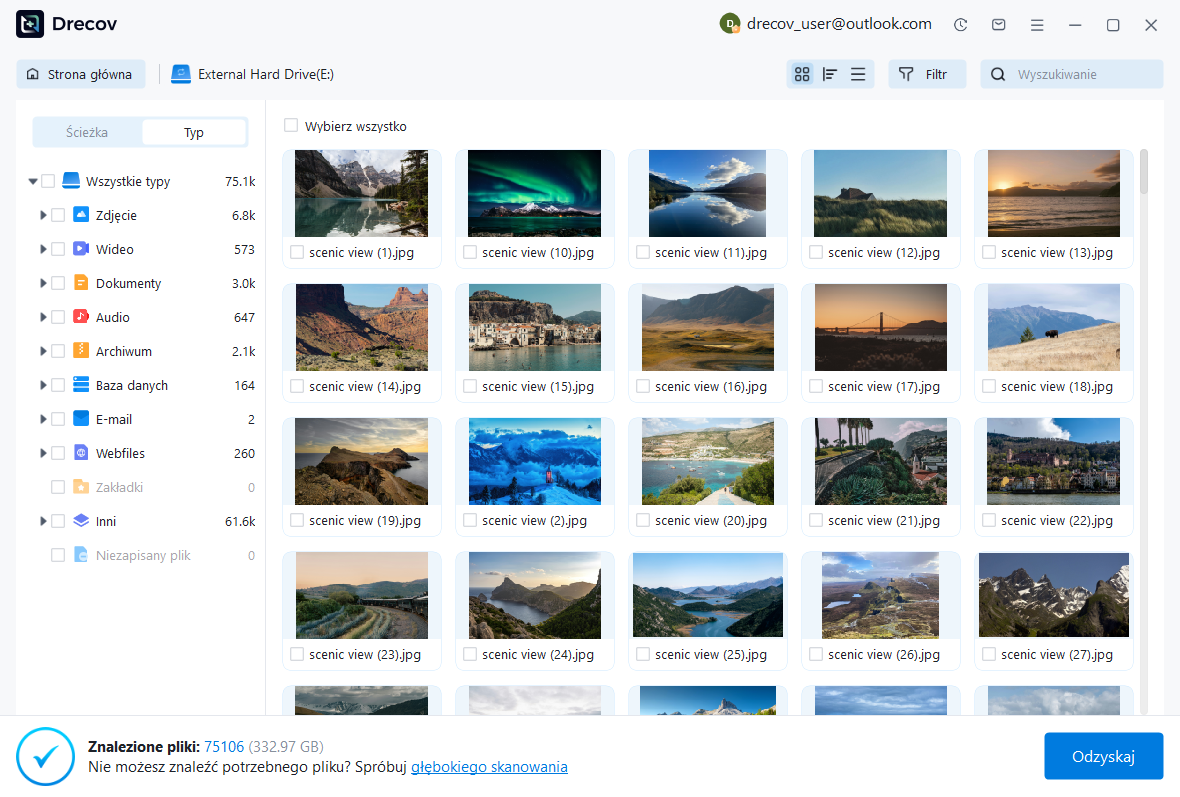
Krok 3: przywróć gdzie indziej i sprawdź stan danych
Odzyskaj wybrane pliki do osobnego miejsca docelowego i zachowaj nienaruszony zestaw. Zaimportuj działające archiwum lub sprawdź odpowiedni skopiowany obszar roboczy za pomocą obsługiwanego przepływu pracy aplikacji. Porównaj historię, znane rekordy, liczniki, kolumny i informacje o uzgodnieniu. Niepewne fragmenty należy trzymać oddzielnie od zaakceptowanego projektu, aby nie zastąpiły zweryfikowanego materiału.
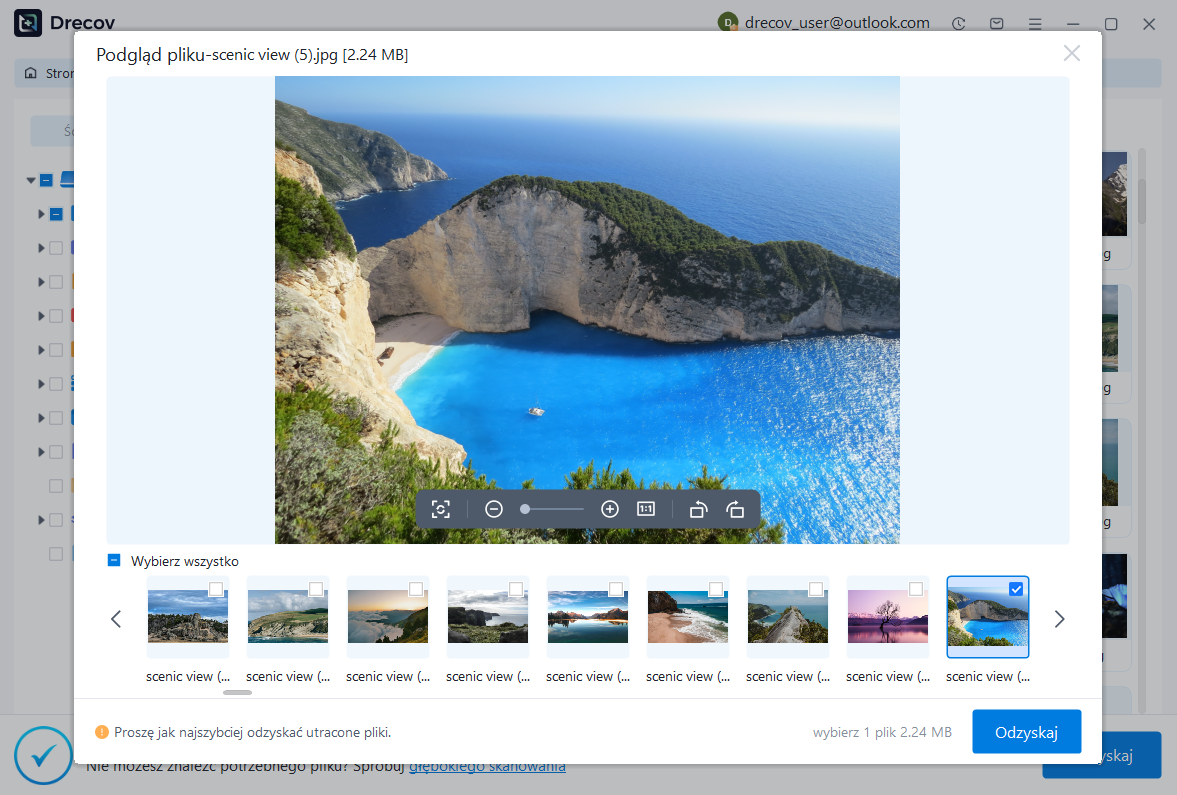
Zachowaj zaakceptowany i możliwy do sprawdzenia projekt
Zapisz źródło obszaru roboczego lub archiwum, wersję danych wejściowych, odzyskaną historię i zrekonstruowane operacje. Następnie zachowaj zarówno natywne archiwum projektu, jak i zamierzony eksport danych z zaakceptowanego kamienia milowego. Daje to następnemu analitykowi niezawodne połączenie między wyczyszczoną tabelą a transformacjami, które ją wytworzyły.
Przetestuj archiwum projektu jako rzeczywiste przywracanie
Użyj skopiowanej próbki, aby sprawdzić, czy archiwum zostanie zaimportowane z oczekiwaną historią i danymi. Następnie porównaj, co zachowuje zwykły eksport, a co pomija. Ten praktyczny test wyjaśnia różnicę między zapisywaniem tabeli a zachowaniem projektu i pomaga zapobiec sytuacji, w której kopia przeznaczona wyłącznie do eksportu stanie się przyjętym planem odzyskiwania dla wszystkich prac analitycznych.
Powiązane zasoby odzyskiwania
Zapoznaj się z odpowiednimi opcjami odzyskiwania: Odzyskiwanie dysku twardego, Odzyskiwanie zewnętrznego dysku twardego.
Aby zapoznać się z innym przypadkiem odzyskiwania środków i jego praktycznymi kontrolami, przeczytaj powiązany przewodnik odzyskiwania.
Sprawdź wskazówki dostawcy dotyczące zainstalowanej wersji: oficjalna dokumentacja odzyskiwania 1, oficjalna dokumentacja odzyskiwania 2, oficjalna dokumentacja odzyskiwania 3.





